В Яндексе трафик есть, а в Google нет: как найти причину
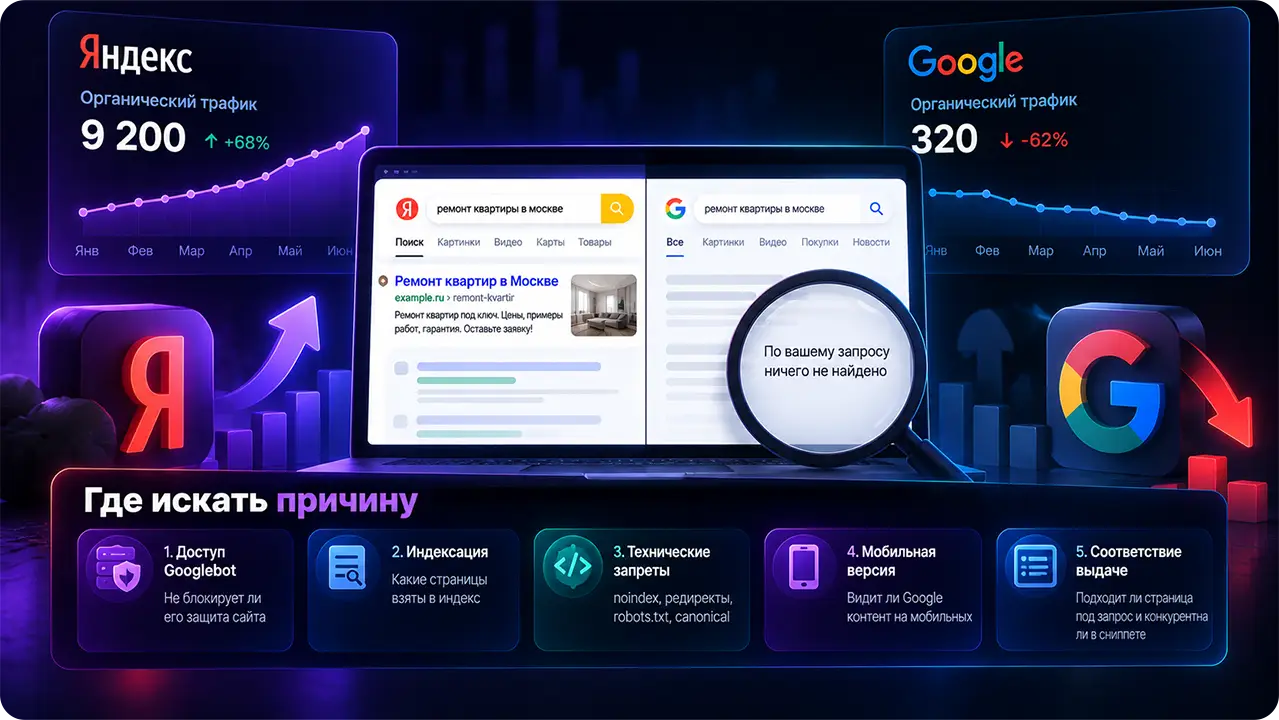
Когда ко мне приходят клиенты с вопросом «почему Яндекс дает заявки, а Google нет», я начинаю проверку не с текстов и ссылок. Сначала смотрю, видит ли Google сайт вообще: пускает ли его защита от DDoS, какие страницы он взял в индекс, а какие отложил.
Разбираю всегда на уровне конкретных страниц. Беру коммерческий URL, от которого бизнес ждет клиентов, выписываю его запросы, регион и дату последнего заметного изменения. Ниже описываю, в каком порядке провожу такой разбор и какие отчеты Search Console, Вебмастера и Метрики смотрю на каждом шаге.
Чаще всего причина находится в одном из пяти мест:
- Googlebot не может зайти на сайт: зарубежные IP режет фаервол или защита от DDoS.
- Google нашел страницы, но не взял их в индекс (статусы «Обнаружена, не проиндексирована» и «Страница просканирована, но пока не проиндексирована»).
- Технические запреты: noindex, редиректы, чужой canonical, правила robots.txt, контент только в JavaScript.
- Мобильная версия беднее десктопной, а Google индексирует именно ее.
- Страница не совпадает с тем, что Google показывает по запросу, или ее сниппет проигрывает соседним.
Бывает и так, что проблемы нет вовсе. Доля Google в российском поиске заметно меньше, чем у Яндекса, и сильно зависит от региона, устройства и тематики. Поэтому «Яндекс дает в три раза больше» само по себе ничего не доказывает. Важнее, как меняется трафик из каждой системы и по каким страницам.
Как отделить брендовый трафик и увидеть настоящую разницу
Суммарный график легко обманывает. Компания запустила рекламу, название бренда стали чаще искать в Яндексе, а Google продолжил приводить читателей в блог. Органика выросла, хотя позиции товарных категорий могли не сдвинуться вовсе.
Поэтому трафик я всегда делю дважды: брендовые запросы отдельно от небрендовых, коммерческие страницы отдельно от информационных. Дальше сравниваю динамику каждой группы внутри своей поисковой системы. У каналов разная аудитория и разный спрос, поэтому одинаковое число кликов из Яндекса и Google целью быть не должно.
В Google Search Console откройте отчет «Эффективность», добавьте фильтр по запросу и выберите специальный фильтр с регулярным выражением. Для условного бренда «АкваПример» выражение может выглядеть так:
(?i)аква ?пример|aqua[ -]?primer
(?i) отключает учет регистра, а вопросительный знак после пробела ловит и слитное, и раздельное написание. В расширенном фильтре Search Console вариант «Соответствует регулярному выражению» оставит брендовые запросы, а «Не соответствует» покажет все остальные. Допишите в выражение частые опечатки, транслит и старые названия компании.
В Яндекс Вебмастере то же самое делается через группы запросов. В фильтре «Текст запроса» варианты названия объединяются символом |. Сохраните выборку в группу «Бренд» и отслеживайте ее в разделе «Эффективность → Статистика запросов». Вторую группу соберите из целевых коммерческих фраз. Тогда рост брендового спроса не закроет собой проблемы каталога или услуг.
Периоды берите сопоставимые. Google и сам советует учитывать сезонность при разборе падений трафика, так что для сезонного бизнеса берите тот же период прошлого года вместо прошлого месяца. В Search Console отдельно разрежьте данные по устройствам: если просело только на мобильных, круг причин сразу сужается. Городскую выдачу проверяйте из нужного региона, потому что фильтр по стране ее не заменит.
Где искать причину: диагностическая таблица
| Что наблюдаете | Где смотреть в Google | Где смотреть в Яндексе | Первое действие |
|---|---|---|---|
| Важного URL нет в поиске | Отчет об индексировании страниц и проверка URL в Search Console | «Индексирование → Страницы в поиске», «Анализ robots.txt», «Проверка ответа сервера» | Проверить доступ робота, noindex, редиректы и canonical |
| Googlebot получает ошибки, а у Яндекса все в порядке | «Настройки → Статистика сканирования»: статус хоста и ответы при сканировании | «Проверка ответа сервера»: если здесь 200, а Google видит 403 или таймауты, ищите фильтр по IP | Пропустить проверенных роботов Google в защите сайта |
| URL в индексе, но нужных показов мало | Запросы по странице в отчете «Эффективность» | Группа запросов и фильтр по URL | Сравнить формат страницы с форматом выдачи |
| Показы держатся, кликов меньше | Запросы, позиции, CTR, устройства и вид в поиске | Показы, клики, CTR и позиции по той же группе | Сравнить заголовок и описание с соседними результатами |
| Посетители приходят не из тех регионов | География в веб-аналитике и проверка локальной выдачи | Региональность сайта, карточка в Яндекс Бизнесе, география в Метрике | Уточнить реальную территорию работы и показать ее на сайте |
| Переходы есть, заявок мало | Сегмент Google в веб-аналитике | «Источники → Поисковые системы» в Метрике, цели и Вебвизор | Проверить предложение, форму и мобильный сценарий |
Таблица не ставит диагноз, она подсказывает следующую проверку: один и тот же симптом бывает у нескольких причин.
Почему Google не индексирует страницу, которую видит Яндекс
Проблемы с индексацией я начинаю разбирать с инструмента проверки URL. Доступна ли страница? Не остался ли noindex после разработки? Куда ведут редиректы? Какой canonical выбрал Google, ваш или другой? Если содержимое подгружается через JavaScript, запустите «Проверить страницу на сайте» и посмотрите скриншот и HTML, которые получил робот.
Если здесь все чисто, смотрю на причины, которые бьют по Google сильнее, чем по Яндексу.
Googlebot не может зайти на сайт
По умолчанию Googlebot сканирует с американских IP-адресов. А часть российских сайтов с 2022 года режет зарубежный трафик: правило в фаерволе, геоблок у хостинга, защита от DDoS с капчей для «подозрительных» стран. Посетитель из Москвы и робот Яндекса ничего не замечают. Googlebot получает 403, капчу или таймаут.
Поэтому у российских сайтов я первым делом открываю в Search Console отчет «Статистика сканирования» в разделе «Настройки». В блоке «Статус хоста» отображаются проблемы с доступом к файлу robots.txt, DNS-преобразованием и подключением к серверу, а в таблице «Ответы при сканировании» видна доля ответов 403 и 5xx. В отчете об индексировании страниц та же проблема выглядит как «Страница заблокирована из-за ошибки 403 (доступ запрещен)» или «Ошибка сервера (5xx)».
Открывать сайт для всех стран не обязательно. Достаточно пропустить настоящих роботов Google: диапазоны их IP-адресов Google публикует, а подлинность робота проверяется обратным DNS-запросом. Пропускать всех, у кого в User-agent написано Googlebot, нельзя. Эту строку подделывает кто угодно.
Google нашел страницу, но не взял ее в индекс
В отчете об индексировании страниц есть три статуса, которые часто путают.
- «Обнаружена, не проиндексирована». Google знает об адресе, но еще не сканировал его. Обычно робот тратит время на тысячи малоценных URL (фильтры, сортировки, параметры) или сервер отвечает медленно.
- «Страница просканирована, но пока не проиндексирована». Google страницу видел и пока решил ее не добавлять. У коммерческих сайтов сюда обычно попадают почти пустые категории, страницы фильтров без своего ассортимента и карточки, которые отличаются от соседних одним параметром.
- «Страница является копией. Канонические версии страницы, выбранные Google и пользователем, не совпадают». Google склеил страницу с другой и показывает ту, другую. Какую именно, видно в проверке URL.
Кнопка «Запросить индексирование» тут мало что решит: она ускоряет сканирование, но не меняет оценку страницы. Помогает другое. Закрыть от обхода мусорные URL, усилить внутренние ссылки на важные страницы, объединить дубли и дать категориям то, чего нет у соседей: ассортимент, удобные фильтры, ответы на вопросы перед покупкой. Яндекс при этом может спокойно держать такие страницы в поиске, отсюда и ощущение, что «Google не любит сайт».
Мобильная версия беднее десктопной
Google индексирует и ранжирует сайт по мобильной версии. Если в мобильной верстке убраны характеристики, отзывы, блок с ценами или перелинковка, для Google этого контента нет, даже когда на компьютере страница выглядит полной. Я сравниваю мобильную и десктопную версии ключевых шаблонов: категории, карточки, страницы услуг. Особенно внимательно смотрю на блоки, которые на телефоне подгружаются только по нажатию.
robots.txt: где Яндекс и Google расходятся
Правила для разных роботов читайте по отдельности: общий блок User-agent: * и отдельные блоки для Googlebot или Yandex могут давать разный результат. Проверяйте конкретный URL, беглого просмотра файла недостаточно.
В Google Disallow запрещает сканирование, но не убирает адрес из поиска. URL может попасть в выдачу по внешним ссылкам, причем без описания. Чтобы исключить доступную страницу, нужен noindex, и робот должен иметь возможность его прочитать.
У Яндекса картина двойственная. В инструкции по удалению страниц Disallow указан как один из способов, но там же оговорено, что закрытая страница иногда может появляться в результатах, например по ссылкам с других ресурсов. А справка по robots.txt говорит прямо: «Ограниченные в robots.txt страницы могут участвовать в поиске Яндекса», и для исключения советует noindex при открытом доступе роботу.
Так что считать закрытую в robots.txt страницу гарантированно удаленной из Яндекса уже нельзя. Выбирайте инструмент под задачу: ограничить обход, убрать живую страницу из выдачи или сообщить, что URL удален. И проверяйте результат в обоих кабинетах.
Показы есть, а кликов нет: посмотрите на саму выдачу
Если страница в индексе, перехожу к запросам. Допустим, вы продвигаете «купить промышленный насос», а посадочной страницей стоит статья об устройстве насосов. Статья может быть отличной, но человеку, который выбирает товар, нужны модели, характеристики и условия покупки.
Дальше открываю выдачу обеих систем по нескольким важным фразам и смотрю, что в ней стоит: категории, карточки, страницы услуг или обзоры. Это и есть ответ, которого ждет пользователь. Если ваша страница другого формата, меняйте формат, сохраняя собственное предложение и отличия от конкурентов.
Когда нужные показы уже есть, сравните свой заголовок и описание с соседними. «Оборудование | Официальный сайт» почти ничего не говорит человеку, который ищет конкретную модель или срок поставки. Обещать в сниппете наличие или цену, которых нет на странице, тоже не стоит. Пользователь просто вернется в выдачу.
Посмотрите, сколько места занимают блоки над обычными результатами. Третья позиция легко оказывается ниже первого экрана телефона. Выдачу я сохраняю на телефоне и компьютере для нужного региона. Это пригодится и для диагностики, и для отчета клиенту.
Google при стабильных показах и падающих кликах советует проверять заголовки, описания и расширенные результаты конкурентов. В справке Вебмастера логика похожая: если показов много, а кликов нет, стоит проверить, соответствуют ли запросу заголовок и сниппет.
И убедитесь, что сравниваете одну и ту же группу фраз. Общий CTR падает и тогда, когда страница просто начала показываться по новым, менее подходящим запросам.
Обратная ситуация: Яндекс не дает трафика из нужного города
Для локального бизнеса начните с раздела «Представление в поиске → Региональность» в Вебмастере. Сопоставьте регион, который определил Яндекс, с адресами, территорией обслуживания и условиями доставки на сайте.
Затем проверьте карточку в Яндекс Бизнесе: адрес, ссылку на сайт, категорию, контакты и часы работы. Если у компании несколько точек, заполненной должна быть каждая. Яндекс определяет регион сайта как раз по данным Вебмастера и Бизнеса.
Потом посмотрите на региональную страницу глазами посетителя. Есть ли там условия для его города? Откуда приедет заказ, сколько ждать доставку или мастера? Название города в заголовке ни на один из этих вопросов не отвечает.
Плодить десятки почти одинаковых поддоменов не стоит. Яндекс прямо предупреждает: если контент поддомена полностью дублирует основной домен или отличается незначительно, адреса будут считаться одним сайтом, и неглавный перестанет участвовать в поиске.
У Google локальная составляющая тоже есть: для местных результатов компаний он называет релевантность, расстояние и известность. Но это правила локального поиска и Карт. Переносить их на всю органическую выдачу как готовую формулу не стоит.
Трафик есть, а заявок нет: что смотреть в Метрике и Вебвизоре
Здесь отчетов поисковых кабинетов уже мало. В Метрике откройте отчет «Поисковые системы» в разделе «Источники», выберите нужную систему и добавьте сегмент по посадочной странице: «Визиты, в которых → Поведение → Страница входа».
Подключите цели. Для услуги это успешная отправка заявки, а для магазина оформленный заказ. Клик по кнопке и полученное обращение считайте раздельно: нажатие еще не значит, что форма ушла или клиент дозвонился.
Отдельно посмотрите мобильные визиты, затем откройте Вебвизор с тем же сегментом. Записи можно фильтровать по устройствам и страницам, так что можно разбирать конкретный сценарий вместо случайной выборки.
В записях я ищу повторяющиеся затруднения: человек несколько раз жмет на неработающий элемент, возвращается к условиям доставки, не может закрыть всплывающее окно, бросает форму на середине. Найденное обязательно воспроизвожу сама. Запись показывает, что произошло, но не почему.
По содержанию страницы проверьте хотя бы четыре вещи:
- Понятно ли, что входит в товар или услугу и что оплачивается отдельно?
- Есть ли цена или хотя бы объяснение, как она считается?
- Видны ли сроки, ограничения и территория работы?
- Можно ли связаться с телефона без лишних действий?
«Стоимость уточняйте» на странице сложной услуги оставляет слишком много неизвестных. Даже если точную цену назвать нельзя, объясните, от чего она зависит и что человек получит после обращения.
Пример из практики: магазин после неудачного переезда на новую CMS
Покажу на проекте интернет-магазина свадебных платьев. Магазин переехал на новую CMS, и позиции просели в обеих системах. Стартовые точки при этом сильно различались: в топ-10 Яндекса оставалось всего 2% отслеживаемых запросов, в Google 16%. Поэтому разбирала я каждую систему отдельно.
При разборе выяснилось, что после переезда не работали редиректы со старых адресов и сбилось управление индексацией.
Что сделали: восстановили 301-редиректы со старых URL на новые, поправили canonical и закрыли от индексации лишнее.
Через три месяца в топ-10 Яндекса было уже 20% запросов, в Google 32%. В Яндексе доля выросла в 10 раз, в Google вдвое. Работы были общими для обеих систем, а отдача оказалась разной, поэтому результат я отслеживала по каждой системе отдельно.
Как превратить диагностику в нормальное техническое задание
Формулировка «улучшить SEO под Google» допускает почти любой набор работ, поэтому в ТЗ я пишу задачи так:
В «Статистике сканирования» Search Console у Googlebot ответы 403, категории каталога в статусе «Страница заблокирована из-за ошибки 403». Настроить в защите от DDoS пропуск проверенных IP Google, повторить проверку URL, отследить статусы в отчете об индексировании страниц.
Или так:
Страница услуги индексируется и получает целевые переходы с мобильных. В записях Вебвизора видно, что форма не отправляется после ввода телефона. Воспроизвести ошибку, исправить форму, сравнить долю успешных отправок за сопоставимые периоды.
С контентом то же самое. Вместо «увеличить статью до нужного объема» я перечисляю вопросы, на которые страница пока не отвечает: совместимость оборудования, ограничения монтажа, состав комплекта, расчет стоимости. Предпочтительного количества слов у Google нет, оценивается полезность материала.
Скорость тоже входит в эту проверку. Core Web Vitals Google учитывает, но хорошие показатели не гарантируют высоких позиций. Ускорять страницу имеет смысл, когда медленная загрузка найдена как проблема, а эффект проверять вместе с остальными метриками.
У каждой задачи в моем ТЗ есть четыре пункта:
- проблемный URL или группу URL;
- симптом и отчет, в котором он виден;
- данные, которые подтверждают причину;
- метрику и срок, по которым станет понятно, сработало ли исправление.
Если подрядчик не может заполнить их для вашего сайта, задача к работе еще не готова.